БЛОГ · · 6 МИН ЧТЕНИЯ
База знаний с ИИ: как устроить поиск по документам компании
Как работает помощник, который отвечает сотрудникам по регламентам компании со ссылкой на источник, что такое RAG и как проверить, что он не выдумывает.
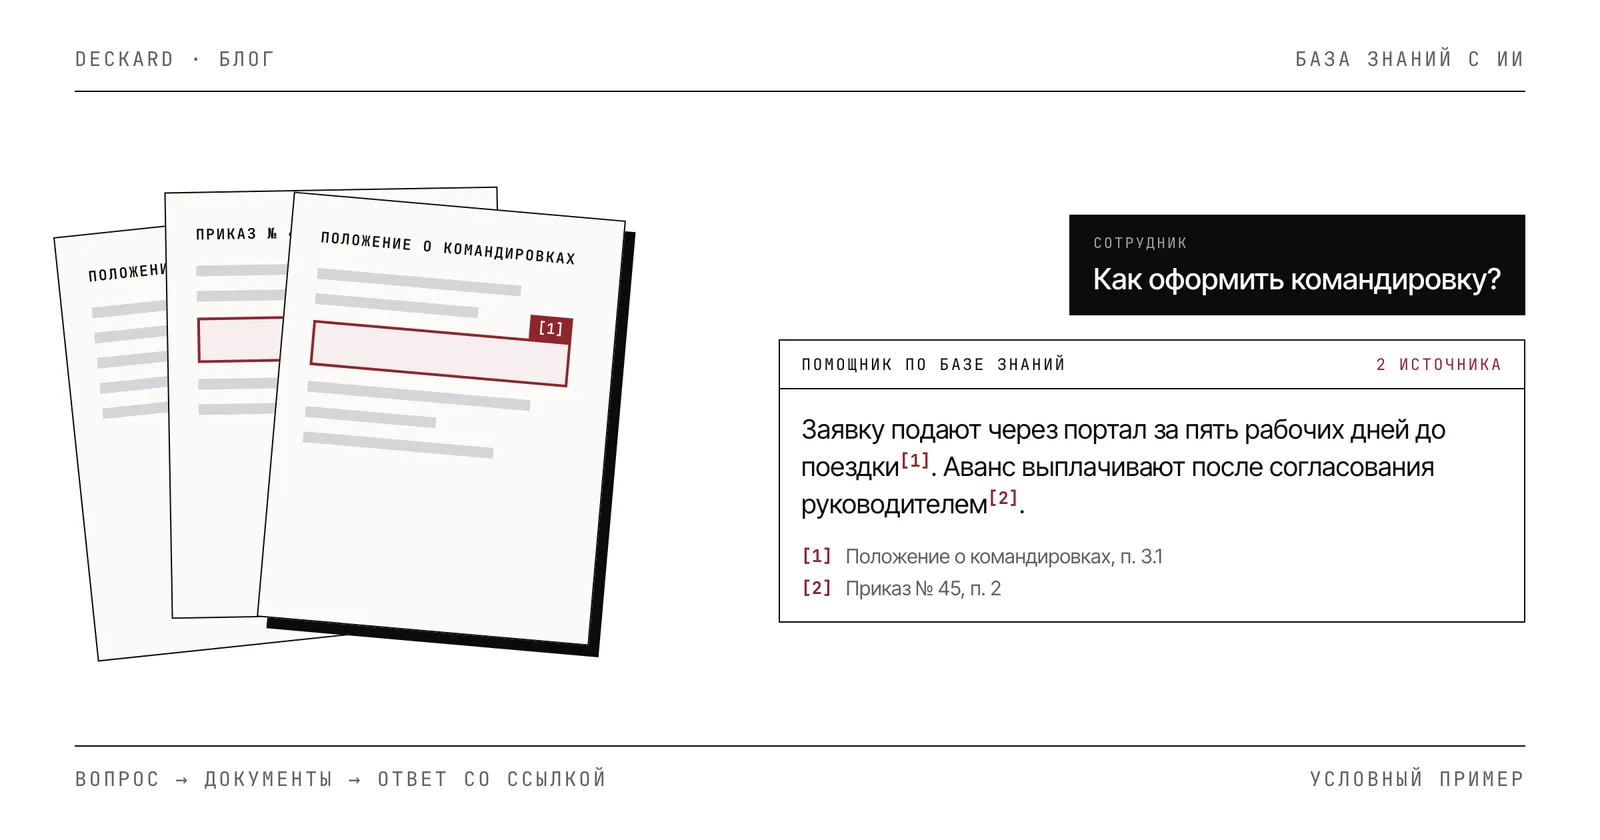
В каждой компании есть вопросы, которые задают по десять раз в неделю. Как оформить командировку, какой допуск нужен для работ на высоте, что делать с возвратом бракованной партии. Ответ записан в регламенте, но регламентов сотни, а проще спросить коллегу, который «точно знает». База знаний с ИИ решает именно эту задачу: сотрудник задаёт вопрос обычными словами и получает ответ со ссылкой на пункт документа, где это написано.
Звучит как обычный чат с нейросетью, но разница принципиальная. В этой статье разберём, чем помощник по базе знаний отличается от ChatGPT, как он устроен, что подготовить до запуска и как проверить, что он отвечает по документам, а не выдумывает.
Чем помощник по базе знаний отличается от чата с нейросетью
Обычная нейросеть ничего не знает о ваших регламентах. На вопрос о порядке командировок она ответит правдоподобно, но по усреднённой практике из интернета, а не по вашему положению. Хуже того, она ответит уверенно, даже если ошибается.
Помощник по базе знаний работает иначе:
- Отвечает только по документам компании. Если ответа в них нет, он так и говорит, а не сочиняет.
- Показывает источник. К каждому ответу прилагается ссылка на документ и пункт, чтобы сотрудник мог проверить.
- Учитывает права доступа. Бухгалтер не получит ответ из документов, которые ему не положено видеть.
- Знает актуальную версию. Когда регламент обновили, помощник отвечает по новой редакции.
Как это устроено: RAG простыми словами
Технически такие помощники строят по схеме RAG — Retrieval-Augmented Generation, «генерация с поиском». Идея простая: модель не пытается вспомнить ответ, а сначала находит нужные фрагменты в документах и отвечает по ним.
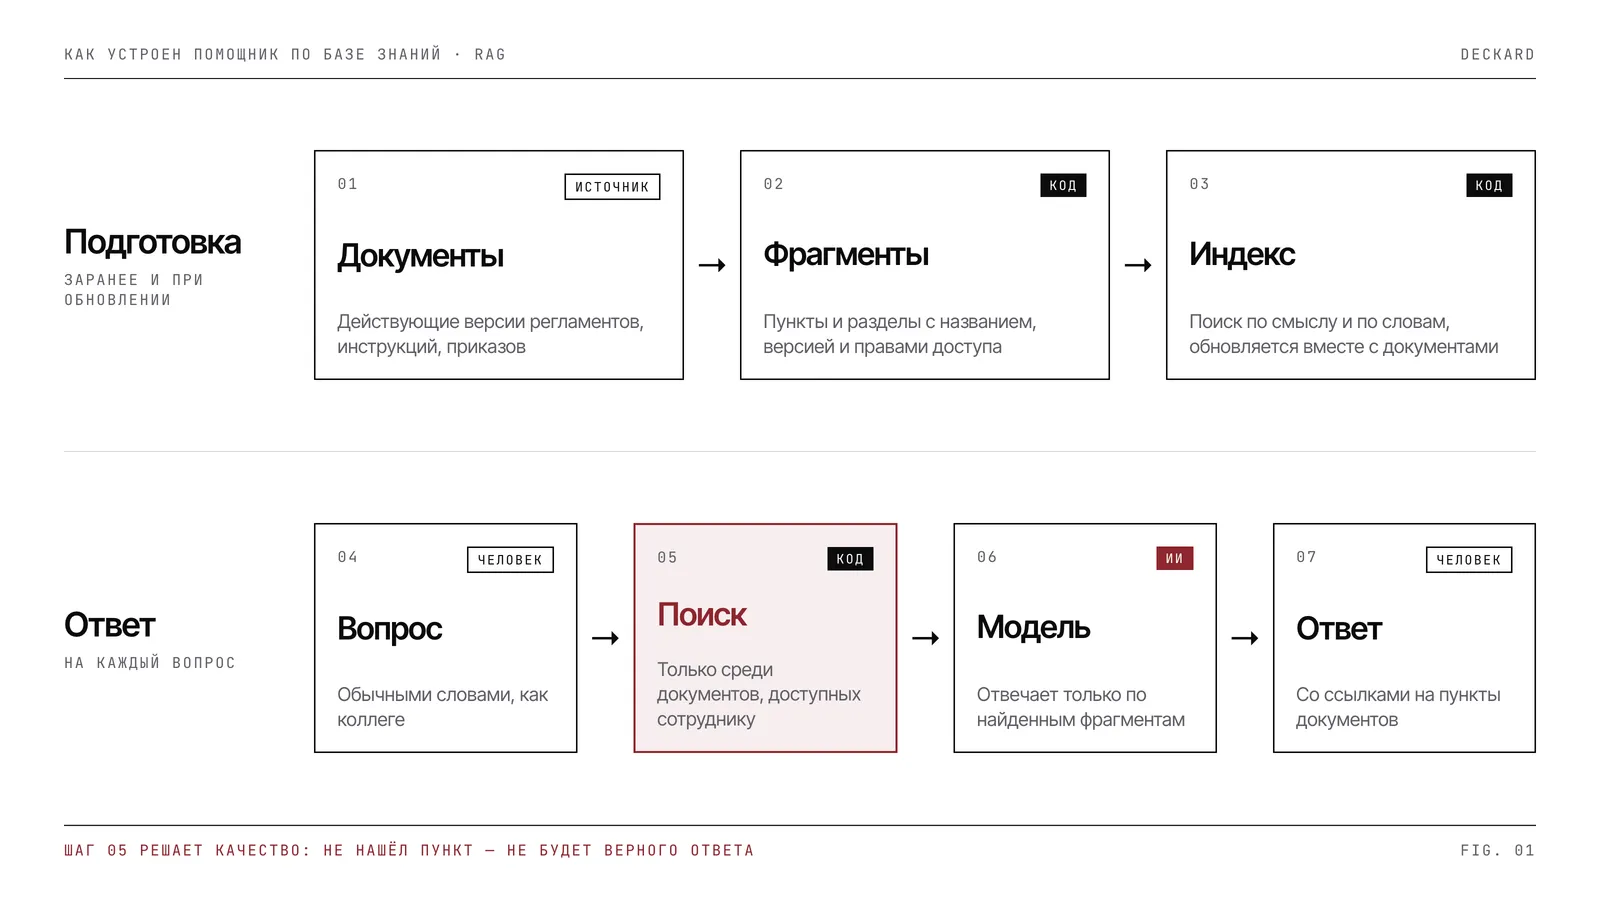
Работа делится на две части.
Подготовка, заранее. Документы разбивают на смысловые фрагменты: пункты, разделы, строки таблиц. Каждый фрагмент попадает в поисковый индекс вместе с названием документа, версией и правами доступа. Когда документ меняется, его фрагменты в индексе обновляются.
Ответ, на каждый вопрос.
- Сотрудник задаёт вопрос обычными словами.
- Поиск находит несколько самых подходящих фрагментов, причём только среди документов, доступных этому сотруднику.
- Модель получает вопрос и найденные фрагменты с инструкцией отвечать только по ним.
- Ответ возвращается со ссылками на фрагменты, из которых он собран.
Качество ответа почти всегда упирается в шаг 2. Если поиск не нашёл нужный пункт, самая сильная модель ответит неправильно или скажет, что не знает. Поэтому основная инженерная работа — не выбор модели, а подготовка документов и настройка поиска.
Что подготовить до запуска
Помощник отвечает так же хорошо, как устроены документы, по которым он ищет. До запуска стоит пройтись по пяти вопросам.
Какие документы действующие. Если в папке лежат три редакции одного положения, помощник найдёт все три и может процитировать устаревшую. Старые версии нужно убрать из поиска или пометить.
Кто отвечает за документ. У каждого раздела базы должен быть владелец, который обновляет документ и получает вопросы, на которые помощник не нашёл ответа.
В каком виде документы. Текстовые файлы и PDF с текстовым слоем обрабатываются легко. Сканы, схемы и сложные таблицы требуют отдельной работы, а иногда проще переписать документ, чем распознавать.
Кто что может видеть. Права доступа лучше взять из уже существующих систем: портала, СЭД или каталога пользователей, а не настраивать заново.
Как будут обновляться данные. Нужна автоматическая синхронизация с местом, где хранятся документы. Ручная загрузка раз в квартал быстро превращает помощника в источник устаревших ответов.
Права доступа: чтобы помощник не рассказал лишнего
Это вопрос, который служба безопасности задаёт первым, и правильно делает. Правило простое: фильтр по правам работает до того, как фрагменты попадают в модель. Модель физически не видит документы, к которым у сотрудника нет доступа, поэтому не может случайно процитировать их.
Ошибка, которую стоит избегать, — отдать модели всё, а потом просить её «не рассказывать лишнего». Инструкции модели — не механизм защиты.
Отдельный вопрос — где работает модель. Если документы нельзя передавать во внешние сервисы, модель разворачивают в контуре компании или используют российского провайдера с подходящими условиями обработки данных. Это решается до выбора конкретной модели.
Как проверить, что помощник не выдумывает
Оценивать помощника «на глазок», задав пару вопросов на демонстрации, нельзя. Нужен тестовый набор.
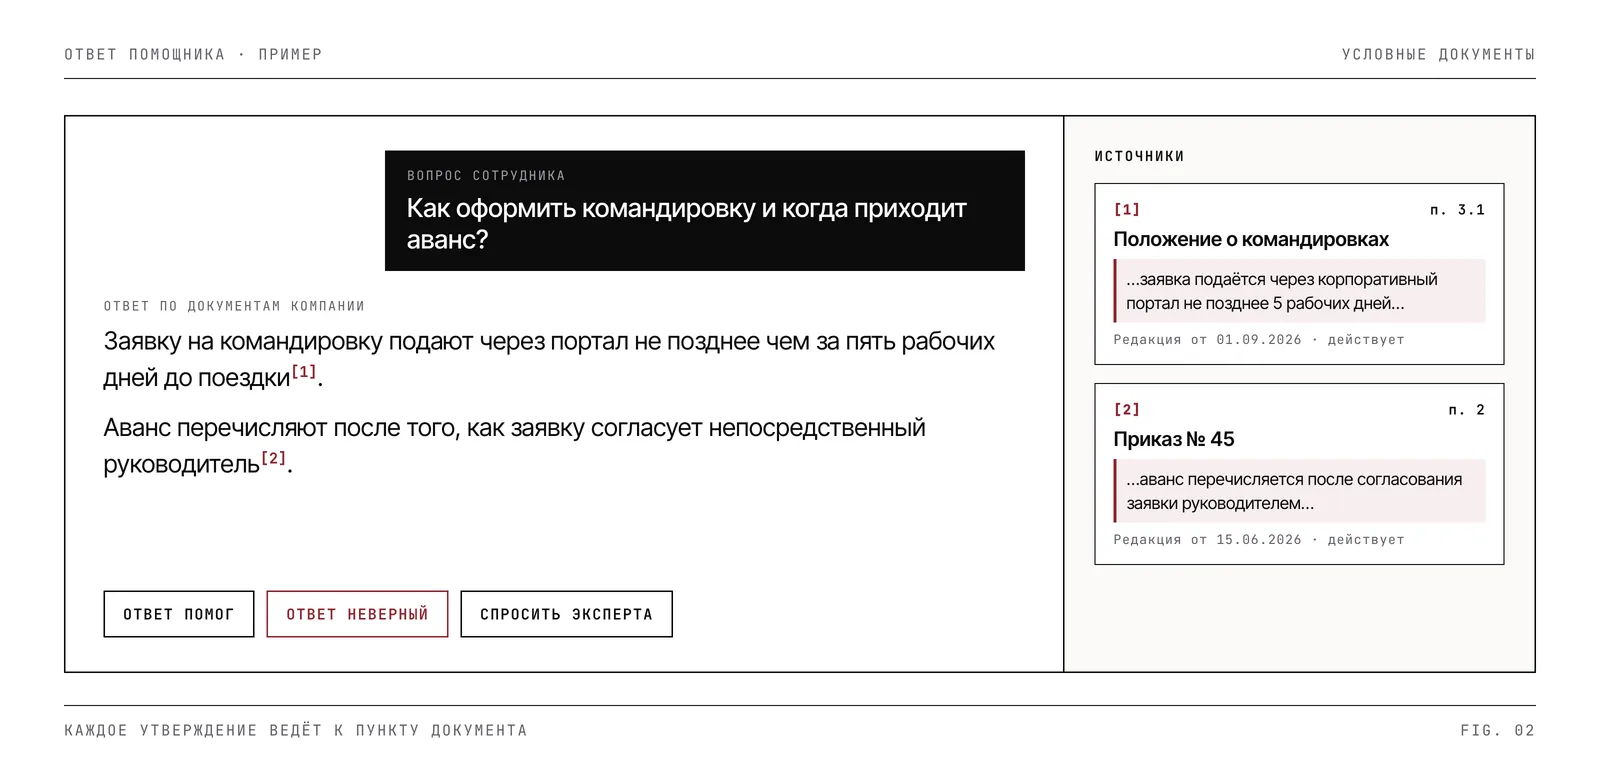
Соберите несколько десятков настоящих вопросов, которые сотрудники задают чаще всего, и для каждого запишите правильный ответ и документ, где он находится. Добавьте несколько вопросов, ответа на которые в документах нет. На этом наборе проверяйте:
- ответ верный и ссылается на правильный документ;
- на вопрос без ответа помощник честно говорит «не нашёл», а не придумывает;
- устаревшие версии не всплывают в ответах;
- сотрудник без доступа не получает ответ из закрытых документов.
Во время пилота добавьте метрики из реальной работы: время на поиск ответа, долю ответов, подтверждённых источником, и долю вопросов, ушедших эксперту. Кнопка «ответ неверный» рядом с каждым ответом даёт поток примеров для улучшения.
Типичные ошибки при запуске
- Загрузить всё подряд. Черновики, переписка и устаревшие версии делают ответы хуже, а не лучше.
- Не показывать источники. Без ссылки сотрудник не может проверить ответ и быстро перестаёт доверять помощнику.
- Не назначить владельцев. Через пару месяцев база устаревает, и помощник начинает отвечать по старым правилам.
- Ожидать, что модель разрешит противоречия. Если два документа говорят разное, помощник это покажет, но решить, какой верный, должен человек.
- Мерить успех числом вопросов. Много вопросов при плохих ответах — это не успех. Смотрите на точность и на то, сколько вопросов ушло экспертам.
Когда база знаний с ИИ не нужна
- Документов немного и вопросов мало. Хорошо организованной папки и оглавления может хватить.
- Знания не записаны. Если ответ живёт только в голове опытного сотрудника, сначала его нужно записать. Помощник не найдёт то, чего нет в документах.
- Для ответа нужны данные из учётных систем. Вопрос «сколько осталось на складе» решает не база знаний, а агент с доступом к складской системе. Это другая задача.
- Документы постоянно противоречат друг другу. Сначала стоит навести порядок в самих регламентах.
Как работать с документами, из которых нужно извлекать данные, а не отвечать на вопросы, мы разбирали в статье «ИИ для работы с документами». А как прикинуть экономию до начала проекта — в статье «Как понять, окупится ли AI-агент».
С чего начать
Не нужно сразу подключать все документы компании. Начните с одного отдела или одной темы:
- Выберите область, где вопросов много, а ответы есть в документах: охрана труда, кадровые вопросы, техническая поддержка, работа с клиентами.
- Соберите самые частые вопросы сотрудников и правильные ответы на них.
- Отберите действующие документы и назначьте их владельцев.
- Проверьте помощника на тестовом наборе, прежде чем показывать сотрудникам.
- Запустите пилот на одной группе и сравните, сколько времени уходило на поиск ответа до и после.
Если помощник отвечает точно и сотрудники им пользуются, можно добавлять следующие разделы базы. Если нет — вы узнаете это на небольшом наборе документов, а не после подключения всего архива компании.