ГАЗЕТА · · 7 МИН ЧТЕНИЯ
Локальная нейросеть для компании: архитектура, расходы и данные
Когда компании нужна локальная нейросеть, из чего состоит свой ИИ-контур, сколько он стоит и почему локальный запуск сам по себе не защищает данные.
«Нам нельзя отправлять документы в ChatGPT, поставим локальную нейросеть». С этой фразы начинается половина разговоров о ИИ в компаниях, где есть персональные данные, коммерческая тайна или строгая служба безопасности. Желание понятное: модель работает на своём сервере, данные никуда не уходят.
Но локальная нейросеть для компании — это не программа, которую ставят за вечер. Это небольшая инфраструктура со своими расходами, а защиту данных она даёт только вместе с правильной настройкой. Разберём, когда свой контур действительно нужен, из чего он состоит, что в нём стоит денег и чего он не решает.
Три варианта: зарубежное облако, российское облако, свой контур
Выбор обычно не между «облаком» и «у себя», а между тремя вариантами.
| Зарубежный облачный сервис | Российский облачный сервис | Свой контур | |
|---|---|---|---|
| Примеры | OpenAI, Anthropic, Google | YandexGPT, GigaChat через API | Открытая модель на своём или арендованном сервере |
| Где обрабатываются данные | За рубежом | В России, у провайдера | У вас |
| За что платите | За объём текста | За объём текста | За сервер и людей, которые его ведут |
| Качество моделей | Самые сильные модели | Сильные модели, лучше знают русский контекст | Зависит от модели и железа, обычно уступает облачным флагманам |
| Сколько времени до старта | Дни | Дни | Недели: сервер, настройка, проверка |
Если вы передаёте персональные данные в зарубежный сервис, это трансграничная передача. С 1 марта 2023 года до её начала оператор обязан уведомить Роскомнадзор, а в страны без «адекватной защиты» персональных данных передавать нельзя ещё 10 рабочих дней после уведомления (Роскомнадзор, статья 12 закона 152-ФЗ). Российский облачный сервис этот вопрос снимает, но данные всё равно покидают вашу инфраструктуру. Подходит ли это вашей компании, решают юрист и служба безопасности, а не подрядчик.
Когда локальная нейросеть действительно нужна
- Данные нельзя передавать никому. Требования регулятора, договоры с клиентами, гостайна, внутренняя политика, которую не меняют.
- Большой и стабильный поток. Когда модель работает весь день на тысячах документов, платить за сервер может оказаться дешевле, чем за каждый токен. Где проходит эта граница, мы показывали в статье «Сколько стоит ИИ-агент».
- Нужна работа без интернета. Закрытый периметр, производство, объекты без надёжной связи.
- Нужно дообучение на своих данных. С открытой моделью вы можете дообучить её под свою задачу и хранить результат у себя.
Если ни один пункт не про вас, начните с облачного сервиса: быстрее проверить, нужен ли ИИ в процессе вообще. Перейти на свой контур можно позже, когда понятны задача, объём и требования к качеству.
Из чего состоит свой ИИ-контур
Модель на сервере — только одна из частей. Чтобы сотрудники могли ею пользоваться безопасно, нужны ещё четыре.
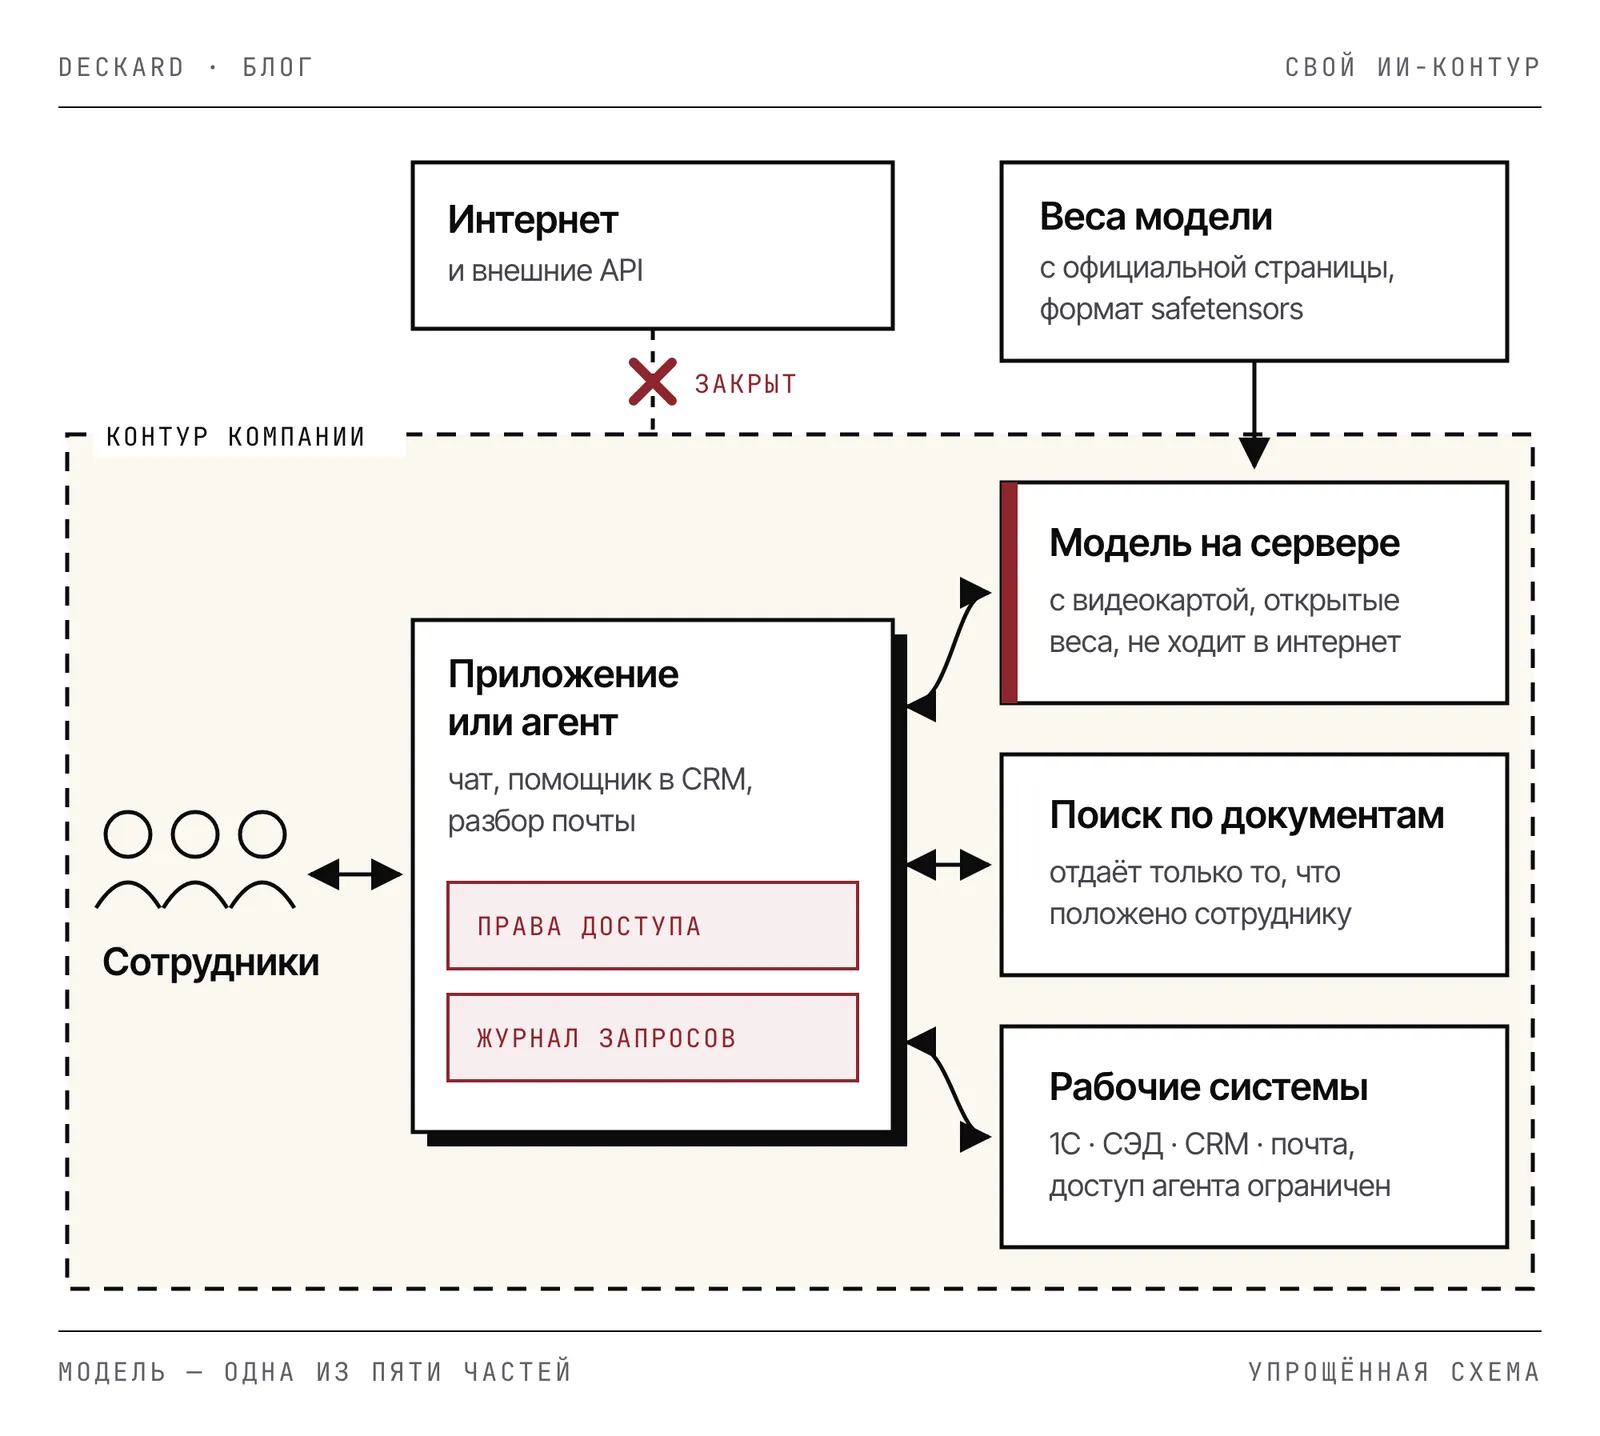
- Модель. Открытая языковая модель, которую разрешено запускать у себя. Из российских, например, GigaChat 3 от Сбера под лицензией MIT (Hugging Face), T-Pro 2.0 от Т-Банка под Apache 2.0 (Hugging Face) и YandexGPT 5 Lite. У последней своя лицензия: использование для внутренних нужд бизнеса считается коммерческим, а после 10 млн выходных токенов в месяц нужно договариваться с Яндексом (лицензия). Лицензию читают до выбора модели, а не после запуска.
- Сервер для модели. Компьютер с видеокартой и программа, которая обслуживает запросы нескольких пользователей сразу, например vLLM. Программы для одного пользователя вроде Ollama хороши для экспериментов на ноутбуке, но не для отдела.
- Приложение. То, с чем работает сотрудник: чат, помощник в CRM или агент, который разбирает почту. Здесь проверяются права доступа и ведётся журнал.
- Поиск по документам. Чтобы модель отвечала по вашим регламентам, а не по памяти, к ней подключают поиск по базе знаний. Как это устроено, мы разбирали в статье про базу знаний.
- Подключения к системам. Локальный ИИ-агент полезен, когда он может прочитать заявку в 1С или СЭД и подготовить ответ. Каждое подключение — это права, которые нужно ограничить.
Сколько стоит свой контур
Железо
Главный параметр — память видеокарты. Вес модели прикидывается простой арифметикой: число параметров умножить на размер одного параметра. Модель на 8 млрд параметров в 16-битном формате занимает около 16 ГБ, после сжатия (квантования) до 4 бит — около 5 ГБ. Модель на 32 млрд параметров — около 64 и 20 ГБ соответственно. Сверху нужен запас на длинные документы и одновременных пользователей, иногда больше, чем на саму модель.
| Задача | Что подойдёт |
|---|---|
| Попробовать, один пользователь | Компьютер с игровой видеокартой на 8–24 ГБ, небольшая сжатая модель |
| Помощник для отдела | Сервер с профессиональной видеокартой на 48–80 ГБ, модель среднего размера |
| Сложные задачи, много пользователей | Несколько видеокарт, крупная модель, балансировка нагрузки |
Сервер можно купить или арендовать с видеокартой у российского облачного провайдера. Аренда быстрее на старте и не требует покупки железа, которое через два года устареет.
Люди и сопровождение
Эту строку бюджета чаще всего забывают. Кто-то должен обновлять модель и программы, следить за нагрузкой и сбоями, проверять качество ответов после каждого обновления и разбирать жалобы пользователей. Это не обязательно отдельный сотрудник, но это обязательно чьё-то рабочее время, своё или подрядчика.
Качество
Самые сильные модели доступны только в облаке. Открытая модель, которая помещается на ваш сервер, может хуже справляться со сложными документами и длинными рассуждениями. Поэтому до покупки железа сравнивают модели на ваших реальных примерах: 30–50 документов или вопросов с правильными ответами. Если локальная модель не дотягивает до нужной точности, экономия на токенах не поможет.
Чего локальный запуск не решает
Модель на своём сервере не отправляет данные провайдеру. Но утечки в ИИ-системах чаще случаются не через провайдера, а через настройку. Раскрытие чувствительной информации стоит вторым в списке главных рисков приложений с языковыми моделями от OWASP (OWASP Top 10 for LLM), и от него не спасает то, что сервер стоит в вашей серверной.
- Права доступа. Если поиск по документам не учитывает права, помощник расскажет менеджеру по продажам о зарплатах бухгалтерии. Модель видит то, что ей дали, а не то, что положено конкретному сотруднику.
- Журналы. Запросы сотрудников и ответы модели с персональными данными оседают в логах. Это тоже обработка персональных данных: нужно решить, кто к ним имеет доступ и сколько они хранятся.
- Выход наружу. Агент с доступом к почте или интернету может отправить данные за периметр, если его обманут инструкцией внутри документа или письма. Права агента ограничивают так же строго, как права нового сотрудника.
- Откуда взята модель. Веса скачивают только с официальных страниц разработчиков и в безопасном формате safetensors, который не может выполнить код при загрузке.
- Кто администрирует. У подрядчика с доступом к серверу есть доступ и к данным. Это решается договором, учётными записями и журналом действий, как с любой другой системой.
Когда локальная нейросеть не нужна
- Данные можно передавать российскому облачному сервису, а поток небольшой: облако будет дешевле и быстрее.
- Задача требует лучшего качества, а открытые модели на ваших примерах заметно уступают облачным.
- Некому сопровождать сервер, и нет бюджета на подрядчика.
- Цель — «чтобы было своё», а конкретного процесса и метрики нет. О том, почему такие проекты застревают, мы писали в статье «Проблемы внедрения ИИ».
С чего начать
- Опишите процесс и данные, которые в нём участвуют, и спросите юриста и службу безопасности, куда эти данные можно передавать.
- Если можно в российское облако — проверьте задачу там: это быстрее и дешевле.
- Если нельзя — соберите 30–50 реальных примеров и сравните на них две-три открытые модели на арендованном сервере.
- Посчитайте полную стоимость: железо или аренда, сопровождение, обновления. И только после этого решайте, покупать ли сервер.
Так вы выбираете локальную нейросеть под задачу и требования к данным, а не под общее ощущение, что «у себя безопаснее».